时览网
Edge0:35B MoE 模型在 Mac 上只需 2.9 GB 内存
我最近在看 Edge0-AI/Edge0 的代码,想弄清楚它怎么让 35B 参数的混合专家模型在一台普通 Mac 上跑起来。传统方案要把所有专家权重常驻内存,35B 模型动辄几十 GB,直接劝退个人设备。Edge0 反过来做:专家权重存 SSD,推理时按需用 mmap 读取,峰值内存只由当前活跃的专家集合决定。35B 模型的 4-bit 量化检查点 23 GB,运行时内存只要 2.9 GB。
目前只支持 macOS 的 Apple Silicon 芯片(M1 到 M4 系列),CUDA 后端还在路线图里。
专家权重按需加载
MoE 模型推理时真正用到的专家是稀疏的,一次前向可能只激活几个。Edge0 把专家权重以 safetensors 格式分片存在 SSD 上,运行时通过 mmap 按偏移量读取对应片段。任何时刻内存里只有当前活跃的 Top-K 专家,这是内存占用能压到 GB 级别的直接原因。
ExpertIo::ShardMaps::raw 是专家权重读取的核心,检查某个分片文件是否已被 mmap 过,没有就打开文件、读取大小、建立内存映射。
const uint8_t *ExpertIo::ShardMaps::raw(const std::string &shard_path, uint64_t off,
                                        uint64_t len) {
  uint8_t *base = nullptr;
  uint64_t total = 0;
  {
    std::lock_guard< std::mutex > lk(mu_);
    auto it = maps_.find(shard_path);
    if (it == maps_.end()) {
      int fd = ::open(shard_path.c_str(), O_RDONLY);
      if (fd < 0) return nullptr;
      struct stat sb;
      if (fstat(fd, &sb) != 0) { ::close(fd); return nullptr; }
      void *m = mmap(nullptr, size_t(sb.st_size), PROT_READ, MAP_SHARED, fd, 0);
      if (m == MAP_FAILED) { ::close(fd); return nullptr; }
用 std::lock_guard 加锁防止多线程同时映射同一文件造成重复映射和资源浪费。用 MAP_SHARED 加 PROT_READ 建立只读共享映射,操作系统的页缓存会被多次读取共享复用。mmap 把"按需读取磁盘文件"变成"按需访问虚拟内存地址",操作系统负责页面换入换出。如果不用 mmap,每次专家切换都要走完整的文件 I/O 和内存拷贝,无法利用页缓存自动复用已读过的数据。
Prerouter 预测下一层专家
专家按需加载会引入延迟,Edge0 用 Prerouter 这个单独训练的小型 MLP 头提前一步预测下一层会用到哪些专家。输入是当前隐藏态和已执行过的专家索引,输出是下一层专家的 Top-K 预测。预测结果和实际的专家加载、前向计算重叠执行,加载磁盘数据的等待时间被计算时间掩盖。
Prerouter::predict 接收每个专家"头"的输入,把隐藏态拷贝进特征向量,再把已执行过的专家索引标记为 1。
bool Prerouter::predict(const std::vector< Input > &in, std::vector< Selection > &out_sel,
                        std::vector< std::vector< double >> *out_logits, std::string &err) {
  if (!impl_ || !impl_->ready) { err = "prerouter: not built"; return false; }
  const int O = n_heads();
  if (static_cast< int >(in.size()) != O) { err = "prerouter: head count does not match input count"; return false; }
  const auto ® = impl_->reg;
  const int64_t prh = reg.prerouter_hidden, E = reg.num_experts, f_in = impl_->f_in;

  std::vector< float > feats(static_cast< size_t >(O) * f_in, 0.f);
  for (int i = 0; i < O; i++) {
    if (!in[i].hidden) { err = "prerouter: missing header hidden input owner=" + std::to_string(owner(i)); return false; }
    float *row = feats.data() + static_cast< size_t >(i) * f_in;
    std::memcpy(row, in[i].hidden, sizeof(float) * impl_->hidden);
    for (int64_t e : in[i].cur_exec)
      if (e >= 0 && e < E) row[impl_- >hidden + e] = 1.f;
prerouter 预测"下一层会用到哪些专家"不能只看当前隐藏态,还得知道这一层已走过哪些专家路径。把已执行专家编码成 one-hot 向量拼在隐藏态特征后面,把上下文显式喂给模型。没有这部分信息,预测会退化成静态预测,准确率下降,预取的专家会和实际需要的不匹配,"加载和计算重叠"优化就会打折扣。
README 提到增益随存储延迟和 K 值增长,最高能到 59%。这个数字的前提是存储延迟较高的场景,如果磁盘本身很快(高速 NVMe),这个增益会相应收窄。
Recover-LoRA 补偿量化精度
4-bit 量化把模型体积压缩到四分之一左右,但会丢精度。Edge0 把 int4 量化后的基模型冻结,用从全精度教师模型蒸馏训练出来的 LoRA 适配器在推理时叠加到基模型上,把量化造成的精度损失补回来。README 的 Quality 表格显示,35B 版本的平均基准损失是 3.9 分,8B 版本是 2.8 分。
这套机制还带来另一个好处,基模型目录下放多组 LoRA safetensors 文件,切换适配器只需替换文件,不用重新加载整个基模型。前提是适配器的 r、alpha 和 owner 元数据必须和基模型匹配。
代码结构与跨平台分层
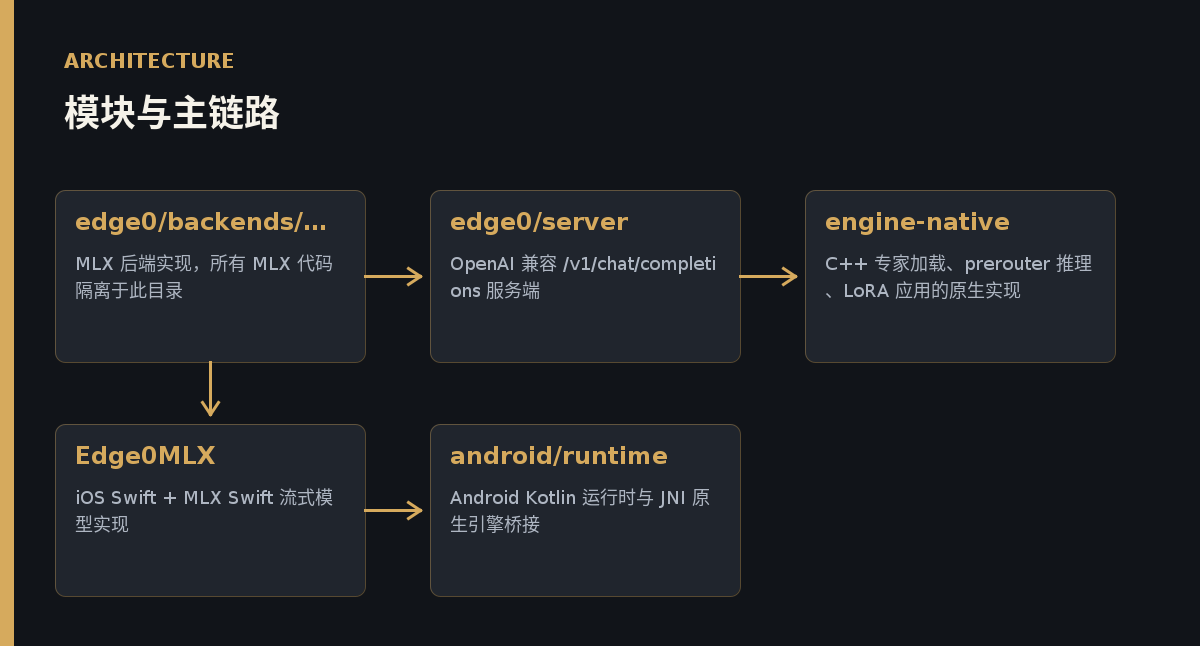
代码库横跨多个平台栈。python/src/edge0/server/ 是 OpenAI 兼容的 /v1/chat/completions 服务端,往下调用 python/src/edge0/backends/mlx/,基于 MLX(Apple 的机器学习框架,专为 Apple Silicon 优化)实现,所有 MLX 相关代码都隔离在这一个目录。
后端抽象层通过 AutoEngine 这个 facade 调用具体后端,MLX 是当前唯一实现,backends/cuda/ 目录已预留。按 README 原话,新增后端只需实现这个 facade,不需要改动核心代码。
重计算部分在 macos/crates/engine-native/ 这个 C++ 实现里,包括专家加载(expertio.cpp)、prerouter 推理(prerouter.cpp)和 LoRA 应用(lora.cpp)。调用链是:prerouter 模块根据隐藏态预测下一层专家索引,ExpertIo 模块拿着索引去 mmap 对应的专家分片取回 Bundle,lora.cpp 把 LoRA 的 delta 叠加到专家权重上,最后参与实际前向计算。
移动端是独立技术栈。iOS 用 Swift 加 MLX Swift 实现(ios/Sources/Edge0MLX/),核心逻辑是 ExpertTensorStore 做流式专家张量加载;Android 用 Kotlin 写运行时,通过 JNI 桥接到原生引擎。这些引擎在 2026 年 9 月底开源,但目前各平台分开集成,统一的跨平台推理框架计划在 2026 年第四季度交付。
本地跑一次
先装依赖,进入 python 目录建虚拟环境:
cd python
python3.12 -m venv .venv && .venv/bin/pip install -e '.[dev,fetch]'
下载 35B tier 的模型文件:
.venv/bin/python scripts/fetch_models.py --tier edge0-35b --target-dir models
设置环境变量指向下载好的模型目录:
export EDGE0_35B_MODEL=$PWD/models/edge0-35b
跑一次演示推理:
edge0 demo edge0-35b
启动 OpenAI 兼容的服务端:
edge0 serve edge0-35b
服务端启动后,用 curl 或任何 OpenAI 兼容客户端调用。限制是只支持 Apple Silicon,需要 MLX 0.30.6 这个具体版本,实际部署时还要给系统进程、tokenizer 和 KV 缓存留出额外内存。
和其他方案的对比
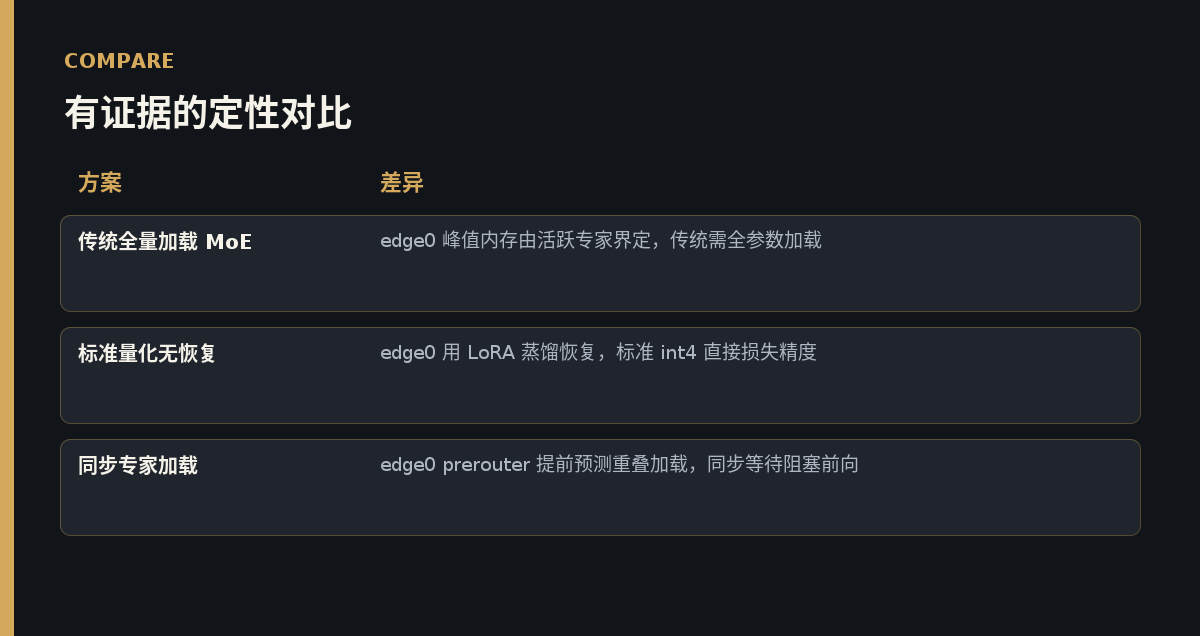
和传统全量加载 MoE 方案比,Edge0 的核心差异是内存占用模型,传统方案要把全部参数常驻内存,Edge0 的峰值内存只由当前活跃的专家集合决定。在 35B 规模上,2.9 GB 对比几十 GB 全量加载,量级完全不同。
和标准 4-bit 量化方案比,差异在精度恢复手段。普通 int4 量化后精度损失直接,没有补救。Edge0 多了一步 LoRA 蒸馏训练,平均基准损失压到 3.9 分和 2.8 分。
和同步专家加载方案比,prerouter 预测加载重叠执行是 Edge0 的特点。这套架构的三个机制组合针对"内存有限但想跑大模型"这个具体场景,对 Apple Silicon 用户确实存在落地空间。但验证范围窄,只在一种硬件、一种后端上跑通,benchmark 数据也只来自单一机型(M4 Pro 24GB),能不能推广到其他配置或芯片代际,现有数据不能回答。
当前的边界
Python 框架目前只支持 macOS 的 Apple Silicon,CUDA 后端还没实现,Linux 和 Windows 上的 GPU 用户现在用不了。只提供 4-bit 量化的检查点,如果需要更高精度或别的量化位宽,得自己转换,项目没有现成转换工具说明。
文档目前只有 README 和 docs 目录,API 细节和测试用例没有专门说明,想深入用需要直接读源码。跨平台统一推理框架要等到 2026 年第四季度,现在 iOS、Android、macOS 三个平台各自独立集成,没有通用接口。
适配器文件依赖配套的元数据,如果目录结构不完整或 LoRA 参数和基模型不匹配,加载会失败。
适合需要在内存受限的设备上跑大规模 MoE 模型的工程师,以及研究稀疏推理、专家调度或 LoRA 适配技术的学术研究者。不适合需要生产级文档支撑、需要跨平台统一 API、或者硬件不是 Apple Silicon 的用户。
项目地址:https://github.com/Edge0-AI/Edge0
审核编辑 黄宇